Le lock GPG qui n'aurait jamais dû exister

Un parc d'une dizaine de VMs qui se déploient elles-mêmes via ansible-pull toutes les 30 minutes. De temps en temps, l'une d'elles arrête de converger, bloquée sur une erreur gpg: waiting for lock ou SQL library used incorrectly. La cause : une tâche qui importait une clé GPG dont plus rien ne se servait, quelque part dans un rôle partagé exécuté par toutes les VMs.
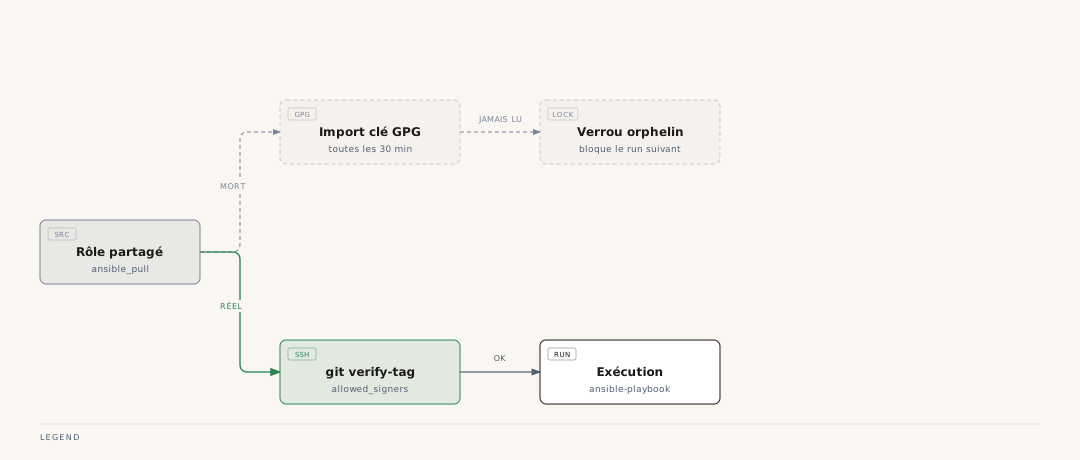
Le symptôme : une convergence qui s'arrête sans prévenir
Le pattern de déploiement est pull-based : chaque VM clone le dépôt, vérifie une signature, applique le playbook, toutes les 30 minutes, sans intervention humaine (voir le post sur le pipeline GitOps signé pour l'architecture complète).
Fiable, jusqu'au jour où j'ai remarqué qu'une VM du parc avait arrêté de converger. Le run échouait avec une erreur GPG plus ou moins cryptique :
gpg: waiting for lock '/root/.gnupg/public-keys.d/pubring.db.lock'...
gpg: keydb: locking failed: File exists
gpg: error reading key: File exists
J'ai redémarré le timer : rien n'y fait, l'erreur revient au run suivant. Pas de dégradation progressive, pas de symptôme préalable : le run passait, puis d'un coup il ne passe plus.
Le vrai mécanisme de vérification n'a jamais utilisé GPG
En creusant, j'ai découvert que la vérification de sécurité réelle du pipeline n'avait jamais reposé sur GPG. C'est git verify-commit / git verify-tag, adossé à des clés SSH listées dans allowed_signers sur chaque VM. GPG n'intervient nulle part dans la chaîne de confiance du déploiement.
Et pourtant, une tâche du rôle partagé (la collection de rôles communs, rôle ansible_pull) importait une clé GPG de signature à chaque exécution, donc toutes les 30 minutes, sur les dix VMs du parc :
# rôle ansible_pull, tâche dépréciée
- name: Import Forgejo GPG signing key
  ansible.builtin.command:
    cmd: "gpg --homedir /root/.gnupg --import {{ ansible_pull_forgejo_gpg_key }}"
  changed_when: false
Une tâche qui ne servait à rien fonctionnellement, mais qui s'exécutait quand même, en silence, depuis la mise en place initiale du rôle.
Pourquoi ça finissait par casser
Chaque gpg --import pose un verrou (dotlock) le temps de l'opération. Sur environ 480 invocations par jour à l'échelle du parc (10 VMs × 48 runs/jour), il suffit qu'un run soit interrompu en plein milieu (timeout, redémarrage de VM, OOM) pour laisser un verrou orphelin, et bloquer tous les runs suivants sur cette même VM.
Deux variantes rencontrées, qui ne se diagnostiquent pas de la même façon :
Verrou mort. Le PID qui le détient n'existe plus.
$ ps -p $(cat /root/.gnupg/public-keys.d/pubring.db.lock 2>/dev/null)
PID TTY STAT TIME COMMAND
# rien : le process n'existe plus
$ rm -f /root/.gnupg/public-keys.d/pubring.db.lock
Verrou vivant. Un processus keyboxd (le daemon qui gère le trousseau GPG moderne) est resté bloqué pendant des jours et tient le verrou légitimement. Supprimer le fichier de lock ne suffit pas : keyboxd le recrée aussitôt. Il faut d'abord le tuer proprement :
$ ps -p $(cat /root/.gnupg/public-keys.d/pubring.db.lock)
PID TTY STAT TIME COMMAND
2841 ?  Sl   0:00 /usr/libexec/keyboxd
$ gpgconf --homedir /root/.gnupg --kill keyboxd
$ rm -f /root/.gnupg/public-keys.d/pubring.db.lock
Sur deux VMs du parc rencontrées lors de cet incident, le PID "détenteur" du verrou était un keyboxd bien vivant, pas un orphelin mort. Supprimer directement le fichier sans le tuer d'abord donne l'impression que ça marche (le run suivant repart), mais le verrou revient dès que keyboxd refait une écriture, cinq minutes plus tard. Toujours vérifier ps -p <pid> avant de conclure à un verrou mort.
Le vrai correctif : supprimer, pas patcher
Une fois que j'ai établi que rien dans la chaîne de vérification ne dépendait de cette clé, ma réponse n'a pas été d'ajouter un nettoyage automatique de verrous au démarrage du timer, ni un retry, ni une alerte de supervision dédiée. J'ai supprimé la tâche, et la variable qui la pilotait, du rôle partagé :
- - name: Import Forgejo GPG signing key
-   ansible.builtin.command:
-     cmd: "gpg --homedir /root/.gnupg --import {{ ansible_pull_forgejo_gpg_key }}"
-   changed_when: false
Zéro invocation GPG restante dans le pipeline, donc cette classe de bug ne peut plus se reproduire par ce chemin. J'ai mergé et tagué le correctif (deploy-2026-08-03-fix-gpg-lock) comme n'importe quel autre changement du dépôt : même pipeline de vérification de signature que celui qui protège tout le reste.
Deux bugs sans rapport, trouvés en passant
En balayant tout le parc pour vérifier que le correctif tenait, j'ai fait remonter deux problèmes préexistants, aucun lié au GPG :
Une VM avec un hostname dérivé. L'OS avait pour hostname ca.admin.exemple.internal (le SAN du certificat TLS du service) au lieu de ca.srv.exemple.internal (le hostname SSH attendu par l'inventaire). Conséquence : --limit "$(hostname -f)" ne matchait plus aucun hôte côté Ansible, et le run échouait silencieusement sans jamais toucher au rôle GPG. Le rôle hostname_fqdn était pourtant correct : c'est l'état réel de la VM qui avait dérivé, corrigé via hostnamectl set-hostname + /etc/hosts.
Un token d'API expiré sur une autre VM, sans rapport non plus : ansible-pull échouait sur l'authentification Git avant même d'atteindre le rôle GPG.
Aucun des deux n'aurait été trouvé sans ce balayage systématique déclenché par un bug par ailleurs sans gravité. Un audit motivé par un petit problème finit parfois par exposer des problèmes plus discrets qui traînaient depuis un moment.
Ce que je retiens
Ce n'était pas un bug de logique, c'était du code mort qui payait un loyer en disponibilité. Le genre de tâche ajoutée un jour "pour être sûr", jamais retirée, qui continue de tourner en silence bien après que sa raison d'être a disparu.
Le signal à repérer : une étape de pipeline qui échoue par intermittence, sans rapport apparent avec ce qu'on vient de changer, mérite qu'on se demande d'abord si elle sert encore à quelque chose avant de chercher à la rendre plus robuste. Ajouter un retry ou un nettoyage automatique aurait masqué le symptôme sans jamais retirer la cause.
Corollaire pratique pour un parc géré en pull : auditer périodiquement les rôles partagés pour repérer les tâches qui n'ont plus de consommateur, en particulier celles qui touchent à des ressources partagées avec verrouillage (fichiers de lock, sockets, caches). Ce sont elles qui, sans jamais rien casser directement, finissent par accumuler ce genre de dette silencieuse.