GitOps sans Vault : réduire le blast radius en vérifiant plutôt qu'en stockant

Déployer un parc de VMs sans serveur central qui pousse la configuration, sans coffre-fort de secrets exposé en permanence, et avec une question simple posée à chaque cycle : "est-ce que ce que je m'apprête à exécuter a été signé par quelqu'un d'autorisé ?" Ce post décrit l'architecture GitOps pull-based que j'ai mise en place autour de cette question, et pourquoi elle réduit mécaniquement la surface d'attaque comparée à un modèle push classique.
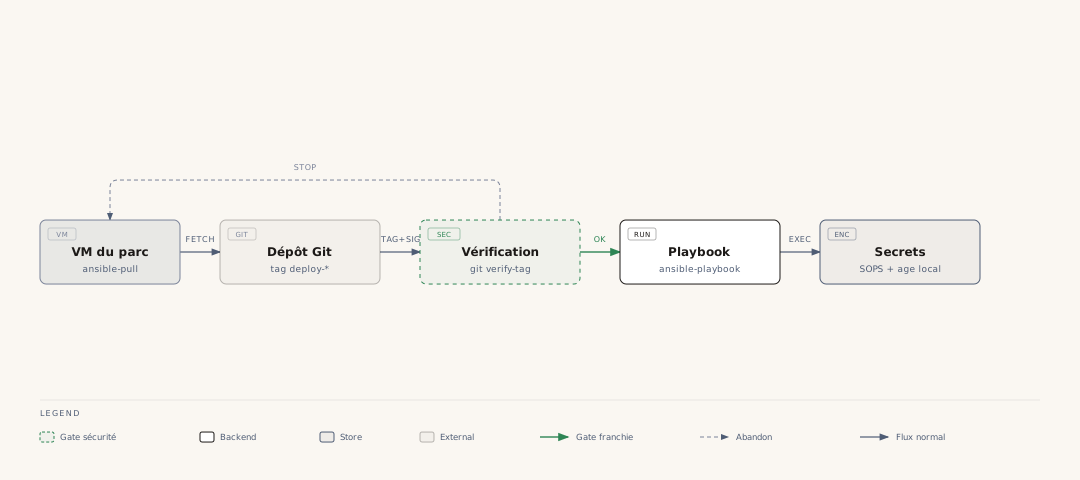
Push vs pull : qui détient le pouvoir d'exécuter
Dans un modèle push classique (Ansible Tower, une CI qui pousse vers la prod, Vault interrogé à la volée...), un serveur central détient des identifiants pour se connecter à toutes les machines et y pousser la configuration. Compromettre ce serveur, c'est compromettre tout le parc d'un coup : c'est la définition même d'un point de confiance unique à haut rayon d'impact.
Dans un modèle pull, chaque VM va chercher sa propre configuration, à intervalle régulier, et personne ne détient de credentials pour se connecter vers les VMs à des fins de déploiement. La question de sécurité change de nature : ce n'est plus "qui peut se connecter à la VM", mais "qu'est-ce que la VM accepte d'exécuter".
Le portier : une vérification de signature avant toute exécution
Le pipeline, exécuté en autonomie par chaque VM toutes les 30 minutes via un timer systemd :
#!/usr/bin/env bash
set -euo pipefail

cd /opt/ansible-pull/ansible-forgejo
git fetch origin
git reset --hard origin/main

TAG=$(git tag --points-at HEAD --list 'deploy-*' | head -n1)
if [ -z "$TAG" ]; then
  logger -t ansible-pull "SECURITY: aucun tag deploy-* sur HEAD, abandon"
  exit 1
fi

if ! git verify-tag "$TAG"; then
  logger -t ansible-pull "SECURITY: signature invalide sur $TAG, abandon"
  exit 1
fi

ansible-galaxy collection install -r requirements.yml
SOPS_AGE_KEY_FILE=/etc/sops/age/deploy.txt ansible-playbook forgejo.yml
Quatre étapes : clone/pull, recherche d'un tag deploy-* qui pointe exactement sur ce commit, git verify-tag contre allowed_signers, et seulement alors l'exécution du playbook avec les secrets déchiffrés localement.
Si la recherche du tag ou la vérification échoue, rien ne s'exécute. Pas de mode dégradé, pas de fallback silencieux : l'échec est la position sûre par défaut. C'est un contrôle self-service : chaque VM applique elle-même la politique de confiance, sans dépendre d'un service central disponible au moment du run.
Forgejo crée toujours un merge commit distinct lors du merge d'une PR, même pour un fast-forward éligible : son hash diffère donc du dernier commit de la branche feature. Il faut créer le tag après avoir rapatrié ce merge commit en local (git fetch && git reset --hard origin/main), jamais avant. Un tag posé sur la branche feature avant merge pointe sur un commit parent du merge commit : ansible-pull ne trouve alors aucun tag deploy-* sur son HEAD et abandonne, avec un message qui part uniquement dans syslog (invisible dans journalctl -u ansible-pull-<repo>), il faut interroger journalctl -t ansible-pull pour le voir.
Pas de Vault : SOPS + age, chiffré au repos, jamais en transit en clair
J'ai fait le choix inverse d'un Vault central : les secrets vivent chiffrés directement dans le dépôt Git (secrets.sops.yaml, via SOPS + age), pas dans un serveur de secrets séparé :
SOPS_AGE_KEY_FILE=~/.config/sops/age/keys.txt \
  sops inventory/group_vars/all/secrets.sops.yaml
Chaque VM détient sa propre clé privée de déchiffrement (/etc/sops/age/deploy.txt), générée localement au premier bootstrap et jamais transmise en clair sur le réseau. Le fichier .sops.yaml à la racine du dépôt liste les clés publiques autorisées à déchiffrer :
creation_rules:
  - path_regex: secrets\.sops\.yaml$
    key_groups:
      - age:
          - age1qdev...          # clé dev (poste de contrôle)
          - age1qforgejo01...    # clé déploiement forgejo01
          - age1qvaultwarden01...# clé déploiement vaultwarden01
Conséquence directe sur le rayon d'impact d'une compromission : la clé de déchiffrement d'une VM ne déchiffre que les secrets pour lesquels elle a été explicitement listée dans .sops.yaml. Compromettre une VM ne donne donc pas accès aux secrets des neuf autres, contrairement à un jeton Vault mal scopé, qui donnerait potentiellement les clés du parc entier s'il est trop largement autorisé.
Et il n'y a tout simplement pas de service Vault à faire tourner, patcher, superviser et exposer sur le réseau : une surface d'attaque en moins, un mécanisme HA en moins à maintenir, un point de panne central en moins.
Le vrai périmètre de confiance : deux domaines à compromettre, pas un seul
Le réflexe naturel est de résumer le modèle de menace à une seule question : qui détient une clé de signature ? C'est incomplet. Il y a en réalité deux domaines de sécurité indépendants, et un attaquant doit compromettre les deux pour obtenir quoi que ce soit :
La sécurité applicative, côté Forgejo : qui a le droit de pousser ou de merger du code sur main. Portée par les permissions du dépôt, les protections de branche, la revue de PR obligatoire pour l'équipe. C'est ce qui empêche un commit malveillant d'atteindre HEAD en premier lieu.
La sécurité par clé, côté signature : qui peut produire une signature valide sur un tag deploy-* pointant exactement sur ce commit. Portée par allowed_signers :
# allowed_signers
[email protected] ssh-ed25519 AAAA...
@cert-authority *.exemple.internal cert-authority ssh-rsa AAAA...
Ces deux domaines ne se recoupent volontairement pas : les droits Forgejo sont gérés dans Forgejo (comptes, équipes, protections de branche), la liste des signataires autorisés vit dans un fichier versionné sur chaque VM, indépendant de tout ce que Forgejo sait ou décide. Compromettre l'un des deux seuls ne donne rien :
- Un compte Forgejo compromis permet de pousser du code malveillant, potentiellement jusque sur
mainsi les protections de branche sont mal réglées, mais ne permet de produire aucune signature valide dessus : aucune VM ne l'exécutera jamais. - Une clé de signature compromise sans droit de push sur le dépôt n'a rien à signer : il n'existe pas de commit malveillant sur lequel l'utiliser.
Un attaquant a donc besoin des deux compromissions à la fois, sur deux surfaces qui n'ont techniquement rien en commun (une application web avec ses comptes et ses sessions d'un côté, du matériel cryptographique et un fichier allowed_signers de l'autre). C'est une différence structurelle avec un modèle où la seule barrière serait "avoir accès en écriture au dépôt" : ici, l'écriture seule ne suffit jamais.
Un raffinement notable sur le second domaine : allowed_signers peut lister à la fois des clés statiques individuelles et une entrée cert-authority pointant vers une CA SSH qui émet des certificats éphémères (voir le post sur les certificats SSH adossés à Entra ID). Ça permet de faire cohabiter un accès nominal, révocable en quelques secondes en retirant une affectation de groupe côté fournisseur d'identité, avec un accès de secours en clé statique réservé au tout premier bootstrap d'une machine neuve.
Ce que ce modèle ne protège pas
Être honnête sur les limites, c'est ce qui rend un post crédible plutôt qu'un post marketing :
- La protection de branche limite déjà la moitié du problème, pas l'autre moitié. Sur ce parc, le push vers Forgejo passe par une clé SSH dédiée, stockée dans un coffre Bitwarden personnel et chargée dans l'agent SSH du poste ; la signature du tag
deploy-*, elle, passe par le mécanisme de certificat éphémère step-ca adossé à Entra ID, réservé au groupeops(voir le post sur les certificats SSH éphémères). Deux mécanismes sans rapport technique. Merger surmainexige déjà l'approbation d'un second membreops(protection de branche), donc un poste compromis seul ne suffit pas à y faire passer du code malveillant. Ce qui reste, en revanche, un acte solitaire : la signature du tag elle-même, une fois le commit légitimement mergé. Rien n'impose de second regard à cette étape précise. Compromettre le poste d'un membreopspendant que son coffre Bitwarden est déverrouillé et sa sessionstep ssh loginactive suffit donc à tagger, seul, n'importe quel commit demaindéjà mergé, y compris un ancien commit qu'on ne voudrait plus voir redéployé. - Le tag doit pointer exactement sur le bon commit. Une erreur de procédure (taguer avant un merge, oublier de re-tagger un dépôt de rôles partagés après modification : un rôle partagé non retaggé bloque silencieusement la convergence de tout le parc, pas seulement d'un repo) casse la chaîne sans que ce soit un problème de sécurité au sens strict, juste un piège opérationnel bien réel.
- Ça ne remplace pas un audit du contenu versionné. Signer garantit qui a produit un commit, pas que ce commit est exempt d'erreur.
Pour aller plus loin : la vraie fenêtre qui reste ouverte
Deux réponses évidentes ne s'appliquent pas ici, et autant le dire plutôt que de les présenter comme des pistes.
La séparation des rôles est déjà en place. La revue à deux avant merge sur main existe depuis longtemps sur ce parc, pas seulement pour cette raison. Le point utile n'est pas de la recommander, mais de noter précisément ce qu'elle couvre : le merge, pas le tag. C'est bien ce déséquilibre-là (une étape à deux contrôleurs, l'autre à un seul) qui définit la fenêtre encore ouverte, décrite plus haut.
Réduire le groupe ops n'a pas de sens ici. L'équipe fait déjà trois personnes. Chercher à isoler un sous-groupe "release" encore plus restreint dans un groupe de trois reviendrait, au mieux, à distinguer une ou deux personnes des deux ou une autres : pas un levier de sécurité sérieux à cette échelle, juste de la complexité en plus pour un gain illusoire.
Sur la clé physique, une vérification s'impose avant de conclure trop vite. Le coffre Bitwarden qui héberge la clé Forgejo est en réalité mieux gardé qu'il n'y paraît au premier abord. Deux réglages changent le calcul : le délai d'expiration de session est fixé à 1h avec verrouillage automatique à l'échéance, et l'agent SSH intégré est configuré pour demander une autorisation explicite dans l'application Bitwarden à chaque utilisation de la clé, pas seulement au déverrouillage du coffre. Concrètement, un malware présent sur le poste ne peut pas se servir silencieusement de la clé Forgejo pendant que le coffre est ouvert : chaque git push déclenche une demande d'autorisation visible, que l'utilisateur doit valider à la main. C'est fonctionnellement proche d'un modèle "validation physique à chaque usage", sans matériel dédié.
Ce qui renverse en partie le constat initial : c'est plutôt le certificat step-ca qui, une fois émis derrière une MFA Entra ID bien réelle, se retrouve ensuite utilisé sans demande de confirmation à chaque usage pendant sa fenêtre de 10h, contrairement à la clé Bitwarden. La MFA protège solidement l'émission d'un nouveau certificat, mais rien n'équivaut, côté step-ca, à ce "toujours redemander" que Bitwarden applique déjà à la signature vers Forgejo.
Le levier concret : un second provisioner, adossé au compte Entra ID admin, pour la seule signature. L'équipe dispose déjà de deux identités par personne : un compte Entra ID courant, utilisé au quotidien, et un compte admin séparé, réservé aux actions privilégiées, comme le veut un modèle d'AD correctement cloisonné. Aujourd'hui, seul le compte courant intervient dans la chaîne step-ca (provisioner entraid-ops, certificat de 10h pour l'accès SSH aux VMs et le déblocage de Forgejo). Rien n'empêche d'ajouter un second provisioner, adossé cette fois au compte admin, dédié exclusivement à l'émission d'un certificat de signature : une fenêtre de 5 minutes, tout juste le temps de créer et signer le tag deploy-*, puis plus rien.
Le partage des rôles devient net : le compte courant sert à travailler (SSH quotidien, Forgejo), le compte admin ne sert qu'à cet instant précis de la signature.
Sauf que le découpage seul ne force rien. Si le compte admin a déjà une session active dans le navigateur (SSO Entra ID), le flux OIDC déclenché par step ssh login --provisioner entraid-admin-sign peut très bien réutiliser cette session silencieusement, sans reprompt ni MFA : la fenêtre de 5 minutes ne protège alors plus grand-chose, elle borne juste la durée d'un certificat obtenu sans aucune friction. Le comportement par défaut d'OIDC, c'est de faire confiance à une session déjà ouverte, pas de la redemander.
Ce qui force réellement une réauthentification, c'est une politique d'accès conditionnel côté Entra ID elle-même, pas un réglage côté step-ca : une politique de fréquence de connexion ("sign-in frequency") réglée sur "à chaque fois", scopée sur l'application (l'App Registration) utilisée par ce provisioner spécifiquement, avec la persistance de session navigateur désactivée pour cette même application. Deux conséquences pratiques : ce provisioner de signature doit avoir sa propre App Registration Entra ID, distincte de celle du provisioner entraid-ops du quotidien (sinon la politique s'appliquerait à tout, y compris le SSH courant), et l'application doit forcer la réauthentification côté serveur d'identité, où elle ne peut pas être contournée par un client qui omettrait de la demander.
Avec cette pièce en place, l'effet cumulé tient : fenêtre d'exposition de 10h à 5 minutes, et une session de travail courante compromise (l'écrasante majorité du temps d'activité d'un poste) qui n'a toujours accès à rien côté signature, faute de session admin active et fraîchement réauthentifiée au même moment. Sans elle, le second provisioner n'aurait été qu'un cloisonnement de façade. Coût annoncé : pas de nouveau matériel, une App Registration et une politique d'accès conditionnel de plus à maintenir, et une discipline déjà à moitié acquise puisque l'équipe bascule déjà sur son compte admin pour les actions sensibles.
La leçon générale
"Zero trust" est souvent réduit à un supplément de sécurité périmétrique. L'idée plus intéressante ici est architecturale : au lieu de faire confiance à un canal (un serveur central autorisé à pousser vers tout le monde), on fait confiance à une preuve vérifiable localement par chacun (une signature), et on réduit mécaniquement le nombre d'endroits où une compromission unique donne accès à l'ensemble du parc.
Ce n'est pas gratuit : ça déplace la complexité vers la discipline opérationnelle (bien taguer, au bon moment, sur le bon commit) plutôt que vers un outil supplémentaire à maintenir. Un compromis que je trouve largement préférable pour un parc de cette taille, mais un compromis quand même, pas une solution magique.