Post-mortem : quand une sauvegarde de routine fige un serveur entier

Un serveur de base de données métier (moteur SGBD propriétaire, sous Ubuntu 22.04) s'est figé un après-midi pendant une sauvegarde qui tournait depuis des mois sans le moindre incident. Huit minutes d'indisponibilité, aucune donnée perdue, mais j'ai fini par relier ce blocage à une saturation mémoire survenue la nuit précédente, sur un mécanisme en apparence totalement différent.
Le symptôme : un serveur qui ne répond plus à rien
16h30. La sauvegarde horaire vers le NAS démarre comme elle le fait 24 fois par jour depuis des mois. Rien d'inhabituel.
16h36, le serveur cesse de répondre. SSH ne connecte plus, la supervision n'a plus rien à afficher, les logs applicatifs s'arrêtent net. Pas de message d'erreur, pas de trace exploitable au moment des faits (juste un silence complet).
16h42, faute de mieux, j'ai redémarré le serveur physiquement, via le bouton d'alimentation. Le serveur revient normalement deux minutes plus tard, la base repart, aucune corruption détectée.
Bilan immédiat : 8 minutes d'indisponibilité, zéro perte de données, et une question qui reste ouverte : qu'est-ce qui a bien pu figer une machine avec 62 Go de RAM et un NVMe, sur une opération de routine qui tourne sans problème depuis des mois ?
Le diagnostic : vm.dirty_background_ratio resté à sa valeur d'usine
Sous Linux, les écritures sur disque ne partent pas immédiatement : elles s'accumulent en mémoire ("pages sales", dirty pages) et un thread de fond (kworker) les vide progressivement vers le disque. Deux seuils pilotent ce mécanisme :
vm.dirty_background_ratio: le pourcentage de RAM en pages sales à partir duquel le noyau commence à écrire en tâche de fond, sans bloquer personne.vm.dirty_ratio: le seuil au-delà duquel tout processus qui écrit doit lui-même attendre que de la place se libère, de façon synchrone.
En creusant, j'ai trouvé ces seuils restés aux valeurs par défaut d'Ubuntu (conçues à une époque où les serveurs avaient quelques Go de RAM, pas 62).
$ sysctl vm.dirty_background_bytes vm.dirty_bytes vm.dirty_ratio vm.dirty_background_ratio
vm.dirty_background_bytes = 0
vm.dirty_bytes = 0
vm.dirty_ratio = 20
vm.dirty_background_ratio = 10
dirty_background_ratio=10 sur 64 Go, ça fait plusieurs Go de marge en théorie. Sauf que ce n'était pas la marge réelle : le calcul se fait sur la mémoire libre, pas sur la RAM totale, et ce jour-là la mémoire réellement disponible était bien plus basse qu'elle n'aurait dû l'être (voir plus bas). Ce que j'ai mesuré concrètement : environ 66 Mo de marge de manœuvre avant que le mécanisme de nettoyage réactif ne s'engage sérieusement (pour une sauvegarde qui écrit à 146 Mo/seconde).
La zone tampon représentait donc moins d'une demi-seconde de marge. Une fois épuisée, chaque processus qui veut écrire doit d'abord attendre que de la place se libère, y compris jbd2, le thread qui tient le journal du système de fichiers ext4 et garantit son intégrité. Il s'est retrouvé bloqué en attente de mémoire, et comme rien ne peut écrire sur le disque sans passer par le journal, l'intégralité du système s'est arrêtée avec lui : la base, la supervision, les logs système.
jbd2 n'a rien à voir avec le moteur SGBD : c'est un composant du noyau, un par système de fichiers ext4/ordered monté avec journalisation. Le blocage n'était donc pas un problème applicatif : n'importe quel processus qui aurait tenté d'écrire au même moment aurait subi le même sort. C'est ce qui explique que la supervision elle-même se soit tue au lieu d'alerter.
Pourquoi ce jour-là, et pas les 200 précédents
Le point le plus instructif de mon enquête : la même sauvegarde, avec le même volume, s'est déroulée sans encombre le lendemain matin. Comparer les deux runs m'a été plus utile que d'examiner l'échec seul.
| Jour de l'incident, 16h30 | Jour suivant, 8h30 | |
|---|---|---|
| Mémoire libre avant la sauvegarde | 18,3 Go | 24,9 Go |
| Mémoire consommée par la sauvegarde | 17,3 Go | 17,1 Go |
| Mémoire restante au plus bas | 0,95 Go | 6,3 Go |
| Résultat | blocage | terminé en 3 minutes |
La sauvegarde a consommé quasiment la même chose les deux jours. Ce qui a changé, c'est la marge dont elle disposait au départ : 6,6 Go de moins le jour de l'incident. Le système tournait donc depuis des mois avec une marge mémoire déjà fragile, sans que ça se voie, jusqu'au jour où elle est passée sous le seuil critique.
Les fausses pistes, écartées une par une
Avant de conclure, j'ai examiné et éliminé quatre hypothèses, preuves à l'appui : la partie la moins spectaculaire de l'investigation, mais celle qui évite de corriger la mauvaise chose.
Le disque est-il défaillant ? Non : j'ai vérifié, smartctl ne montre aucune erreur matérielle sur les 7 jours précédents.
Le moteur SGBD a-t-il planté ? Non. Le moteur a été bloqué comme tout le reste au même instant : il subit le gel, il ne le déclenche pas.
Le pilote de sauvegarde du NAS est-il en cause ? Piste séduisante au premier abord : le pilote (Synology Active Backup) affiche un message d'erreur en fin de sauvegarde. Vérification faite, ce message était apparu 16 fois depuis le redémarrage sans jamais provoquer le moindre blocage, et le correctif amont disponible est documenté comme une simple réduction de bruit dans les logs, pas une correction de bug. Recompiler un composant noyau bas niveau en production pour supprimer un message inoffensif aurait été un risque gratuit. Piste abandonnée.
Est-ce le même mécanisme que la saturation mémoire survenue la nuit suivante (voir plus bas) ? En apparence non : deux symptômes différents, deux horaires différents. Mais creuser cette question a fini par révéler qu'ils partagent la même cause profonde.
La cause plus profonde : un job qui relit toute la base chaque nuit
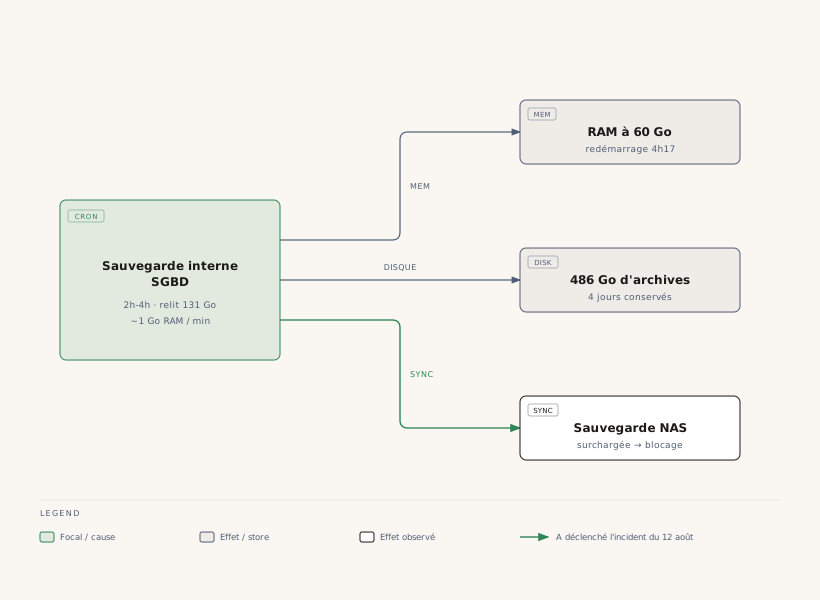
En cherchant pourquoi la marge mémoire était si basse ce jour-là, j'ai remonté jusqu'à un phénomène qui n'avait rien à voir avec la sauvegarde NAS : un job de sauvegarde interne au moteur SGBD, qui tourne chaque nuit de 2h à 4h06.
Le comportement mémoire du moteur (dbengine64) est parfaitement stable en journée :
22h00 à minuit, 120 relevés à 1 min d'intervalle : consommation stable, variation de 3 Mo
Puis, à 2h55 précises, la consommation décolle :
02h54    4,7 Go
02h55    5,3 Go
02h58   12,4 Go
03h12   27,8 Go
03h5x   60,4 Go   ← sur une machine qui en compte 62,5
Environ 1 Go par minute, pendant une heure. Ce n'est pas une fuite progressive, c'est une commande : ce job relit l'intégralité des 131 Go de fichiers de la base à travers le moteur, et le moteur garde en mémoire tout ce qu'il a lu.
Le problème, c'est que cette mémoire n'est pas récupérable de la même façon qu'un cache disque classique. Le cache page du noyau, lui, peut être vidé instantanément dès qu'un processus a besoin de place : tout ce qu'il contient existe déjà ailleurs sur disque. La mémoire privée allouée par le moteur, en revanche, n'est pas visible du noyau comme du cache récupérable : pour en libérer, la seule option du système est de la faire transiter vers le swap, page par page (lent, et ça bloque tout le reste en attendant).
Cette nuit-là, le swap (8 Go) a fini par se remplir entièrement, et le service a redémarré automatiquement à 4h17.
Trois symptômes, une seule origine
C'est là que les deux incidents, traités séparément au départ, se rejoignent :
| Symptôme observé | Origine |
|---|---|
| La RAM du moteur monte à 60 Go et le service redémarre à 4h17 | le job relit 131 Go à travers sa mémoire privée |
| 486 Go occupés sur le disque local | le job y écrit ses archives, 4 jours d'historique conservés |
| Le serveur se fige le 12 août à 16h36 | ces 486 Go d'archives sont vus comme des données "neuves" par la sauvegarde externe, ce qui gonfle son volume et sa durée |
Le disque était occupé à 72 %, dont 486 Go de sauvegardes locales pour seulement 131 Go de données vives. Autrement dit, la sauvegarde vers le NAS passait l'essentiel de son temps... à sauvegarder des sauvegardes.
Les correctifs, appliqués sans coupure de service
1. Élargissement de la zone tampon mémoire. J'ai fixé vm.dirty_background_bytes explicitement à 2 Go (au lieu d'un pourcentage calculé sur une mémoire libre déjà fragile), avec un recyclage plus réactif :
# /etc/sysctl.d/99-dirty-pages.conf
vm.dirty_background_bytes = 2147483648
vm.dirty_bytes = 4294967296
Pour reprendre l'ordre de grandeur : la marge de réaction passe d'environ une demi-seconde à plus de 6 secondes à 146 Mo/s. Coût : 2 Go de RAM réservés en permanence, soit 3 % du total (largement acceptable sur une machine à 62 Go).
2. Lissage des écritures. Le seuil dirty_bytes (au-delà duquel le système force l'écriture synchrone) a été abaissé pour étaler la charge au lieu de la concentrer en à-coups.
Une première estimation proposait de plafonner dirty_bytes à 1 Go. Vérification faite sur une journée complète de production, les pics réels d'écritures en attente atteignaient 5,3 Go : un seuil à 1 Go aurait donc ralenti la base en permanence, bien avant tout incident. La valeur a été corrigée à 4 Go avant application. Sans cette vérification, le correctif aurait remplacé un incident rare par une dégradation permanente.
3. Plafond mémoire sur le service de sauvegarde externe. J'ai ajouté une limite systemd pour que l'agent Synology ne puisse plus, structurellement, menacer la mémoire globale de la machine :
# /etc/systemd/system/active-backup-agent.service.d/override.conf
[Service]
MemoryMax=8G
MemoryHigh=6G
4. Supervision corrigée sur deux angles morts.
L'agent de supervision était lui-même bloqué pendant l'incident : il ne pouvait donc pas signaler le problème pendant qu'il se produisait. J'ai ajouté une alerte sur l'absence de remontée de métriques, en complément des alertes classiques "service arrêté", pour détecter un serveur figé et non pas seulement un service mort.
L'indicateur mémoire affiché jusque-là était trompeur : Zabbix remontait la mémoire "disponible" au sens large (cache inclus), qui est restée affichée à 33,8 Go pendant tout l'incident sans jamais bouger, alors que la mémoire réellement libre s'effondrait à 950 Mo au même moment. Le nouvel item suit MemAvailable (et non le cache brut), avec seuil d'alerte à 3 Go et alerte prioritaire à 2,2 Go :
# Item Zabbix corrigé
UserParameter=mem.available.mb,awk '/MemAvailable/{print int($2/1024)}' /proc/meminfo
Ce qui reste ouvert
Les correctifs rendent le système tolérant à une marge basse : ils ne suppriment pas la cause. Le job de sauvegarde interne continue, chaque nuit, de relire l'intégralité de la base à travers la mémoire du moteur. Trois pistes organisationnelles restent à trancher, plus proches de l'arbitrage métier que de la technique pure :
- Exclure le dossier d'archives locales de l'image système Synology. Le volume à imager passerait de 633 Go à environ 148 Go (le plus gros gain pour le moindre effort) : ces données sont déjà des sauvegardes, les imager n'apporte aucune protection supplémentaire.
- Espacer l'image système, qui tourne actuellement toutes les heures alors que rien sur l'OS ne change à cette fréquence : une image quotidienne suffirait à reconstruire la machine, les données métier restant protégées à leur propre fréquence.
- Déporter les sauvegardes de la base vers le NAS, non compressées. Ce dernier point a son importance : le NAS déduplique (deux sauvegardes successives d'une base peu modifiée partagent 95 à 99 % de leur contenu), mais une archive compressée change intégralement au moindre octet modifié : la déduplication tombe à zéro et l'archive entière est retransmise à chaque fois. Le NAS applique de toute façon sa propre compression après déduplication, dans le bon ordre.
Une piste complémentaire reste à explorer auprès de l'éditeur du moteur : sa configuration actuelle ne comporte aucun plafond mémoire global. Si un tel paramètre existe, il traiterait le problème à sa vraie racine plutôt qu'en périphérie.
Ce que je retiens
Un paramètre système resté à sa valeur d'usine peut rester invisible pendant des mois, jusqu'à ce qu'une charge par ailleurs anodine tombe, un jour, avec une marge un peu plus faible que d'habitude. Le vrai signal n'était pas "la sauvegarde a planté le serveur" mais "pourquoi la marge mémoire était-elle si basse ce jour-là" : c'est cette question, pas le blocage lui-même, qui a fini par exposer un problème de fond sans rapport apparent avec l'incident initial.
Deux réflexes à en retenir pour la prochaine investigation de ce genre :
- Comparer un run qui échoue à un run qui réussit dit souvent plus qu'analyser l'échec seul.
- Un indicateur de supervision qui ne bouge jamais pendant un incident n'est pas rassurant : c'est un signal qu'il mesure la mauvaise chose.